Claudeのアプリを開いたら、モデルを選ぶところに 「Opus 5.5」 という新しい名前が増えていました 👀
しかもネットでは、
- 「新しいOpusが、上のランクのFableを超えた!」
- 「しかも60%も安い!」
という話であふれています。
でも、毎日Claudeを使っているだけの私たちからすると、正直こう思いますよね。
「で、ぶっちゃけ、どっちを使えばいいの?」 🤔
今日はこの疑問に、公式の資料までさかのぼって確かめた答えでお返事します。
Claudeアプリの更新でOpus 5.5が使えるようになった経緯は、こちらの記事で紹介しています。
https://note.com/murabito_s/n/nbce9037f7894
🎯 結論:ふだんは「Opus 5.5」。ただし"本気モード"で使う
先に答えを言います。
📝 文章・調べもの・ふだんの相談には、Opus 5.5。
🧮 表の整理・事務作業にも、Opus 5.5。
🏗️ 何時間もかかる大仕事や、資料を最後まで仕上げる仕事には、Fable 5.1。
😵 Opusで2回つまずいた難問も、Fable 5.1に切り替えます。
そして、いちばん大事な注意がひとつあります。
⚠️ Opus 5.5 は「考える深さ」を上げたときだけ、Fable と互角以上になります。 浅い設定のまま使うと、Fable に負けます。
この「考える深さ」が、今回のニュースのいちばんの落とし穴でした。順番に説明します。
🔍 理由①:「Opusが超えた」は本当。でも"本気モード"での話
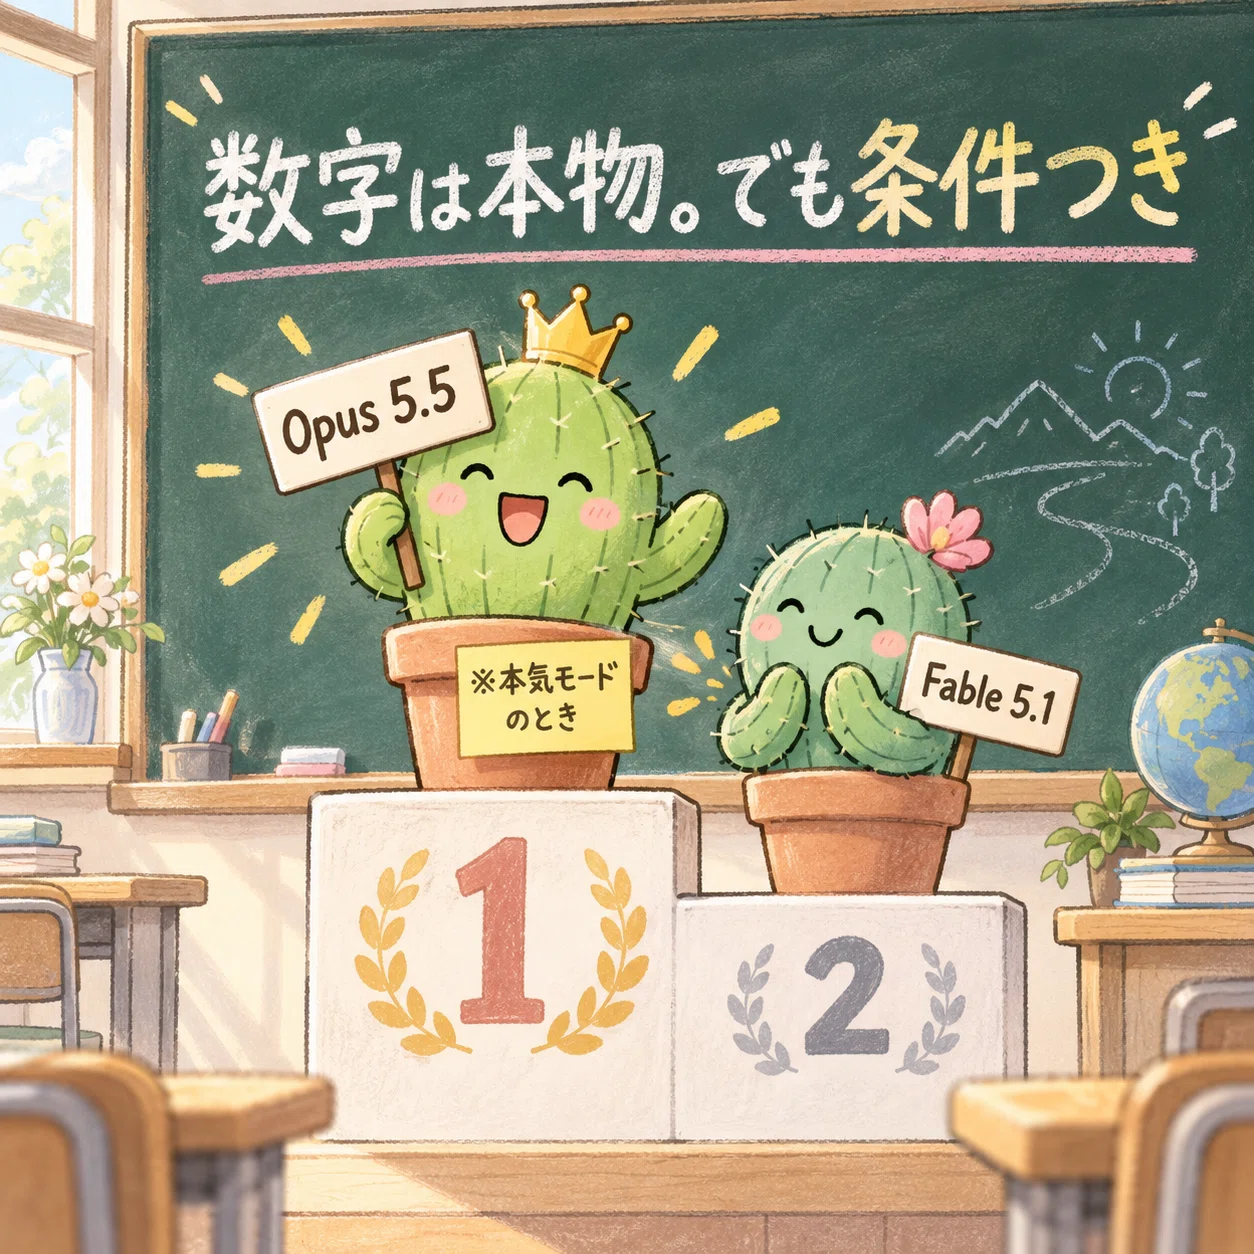
まず、ニュースの数字そのものは 本物 でした ✅
AIを外から採点している会社(Artificial Analysis)の「総合の賢さ」の点数では、
- Opus 5.5:58点
- Fable 5.1:53点
たしかにOpusが上です。AnthropicというClaudeを作っている会社が自分で出した比較表でも、9項目すべてでOpus 5.5が上でした。
📌 補足①:ベンチマークとは? AIの「実力テスト」のことです。国語や数学のテストのように、同じ問題をいろいろなAIに解かせて点数をくらべます。
ところが、この「58点」には条件がついていました。
📌 補足②:「考える深さ」とは? AIが答える前に、どれくらいじっくり考えるかの設定です。深くすると答えは良くなりますが、時間がかかり、使える量(上限)も多く減ります。「中」「高」「超高」「最大」のように段階があります。
58点は、Opus 5.5をいちばん深く考える設定(最大)にしたときの点数なんです。 設定を変えると、点数はこう変わります 👇
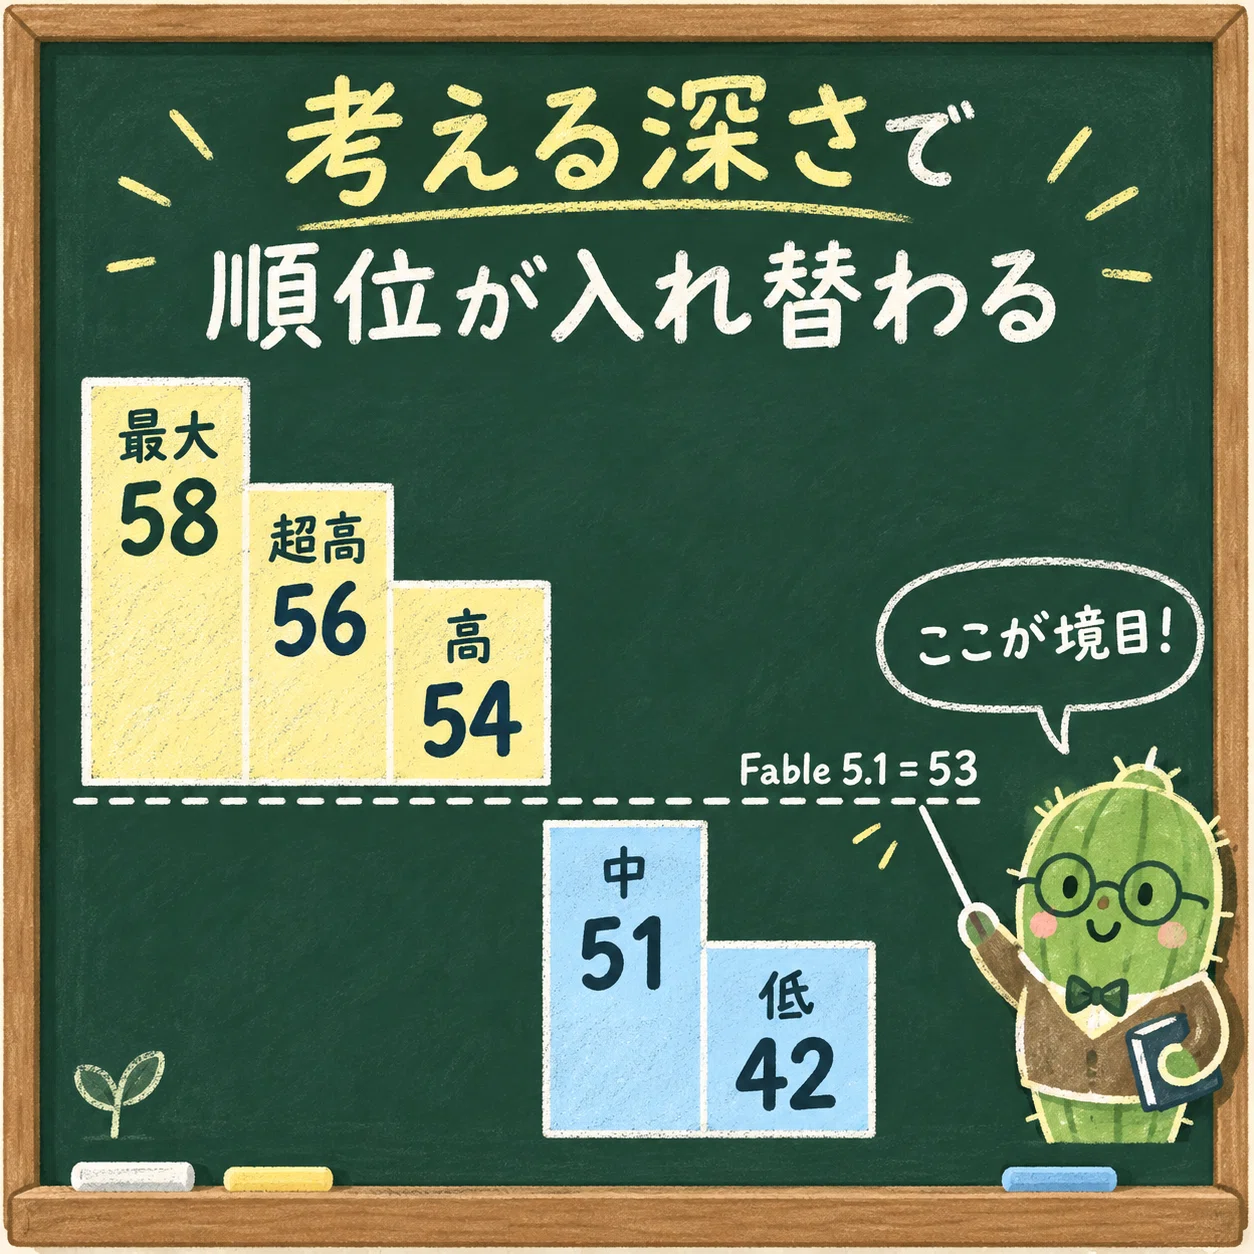
🟢 最大:58点。Fable 5.1の53点より上です。
🟢 超高:56点。こちらもFableより上です。
🟡 高:54点。Fableとほぼ同じです。
🔴 中:51点。ここからはFableのほうが上です。
🔴 低:42点。Fableがかなり上になります。
つまり、
Opus 5.5 は「本気を出せば」Fable より強い。でも「さらっと」答えさせると Fable に負ける。
これが「Opusが超えた」の正体です 💡
さらに、Anthropic自身が発表の中でこう書いています。
「このレベルになると、テストの点差は、実際の使い心地の差を正しく表さなくなってきた。私たちが自分で使った感じでは、Opus 5.5とFable 5.1の差は、点数が示すより小さい」
作った会社の人たちも「ほとんどの仕事では同じくらい」と言っているわけですね。
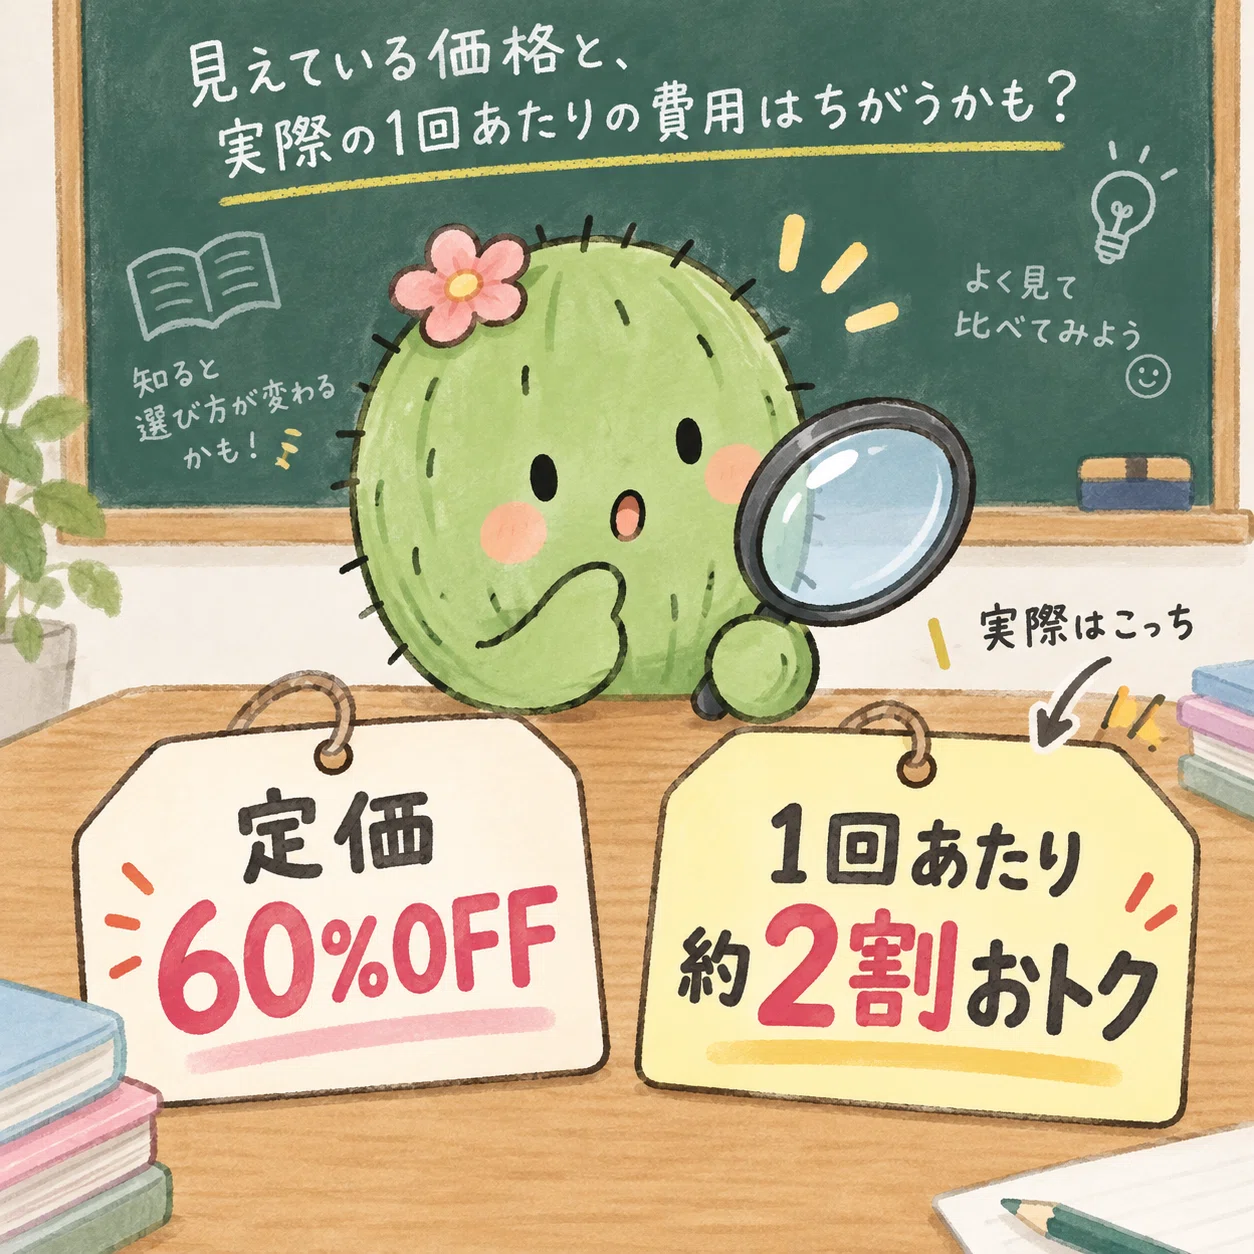
💴 理由②:「60%安い」も本当。でも"1回あたり"は約2割
次は値段の話です。
開発者向けの定価で見ると、Opus 5.5はFable 5.1よりちょうど60%安いです ✅
📌 補足③:「100万トークンあたり」とは? AIの料金は「文字の量」で決まります。トークンは、AIが読み書きする文字の小さなかたまりのことです。日本語だとだいたい1〜2文字くらいだと思ってください。
読むときの定価:Opus 5.5は4ドル、Fable 5.1は10ドル。
書くときの定価:Opus 5.5は20ドル、Fable 5.1は50ドル。
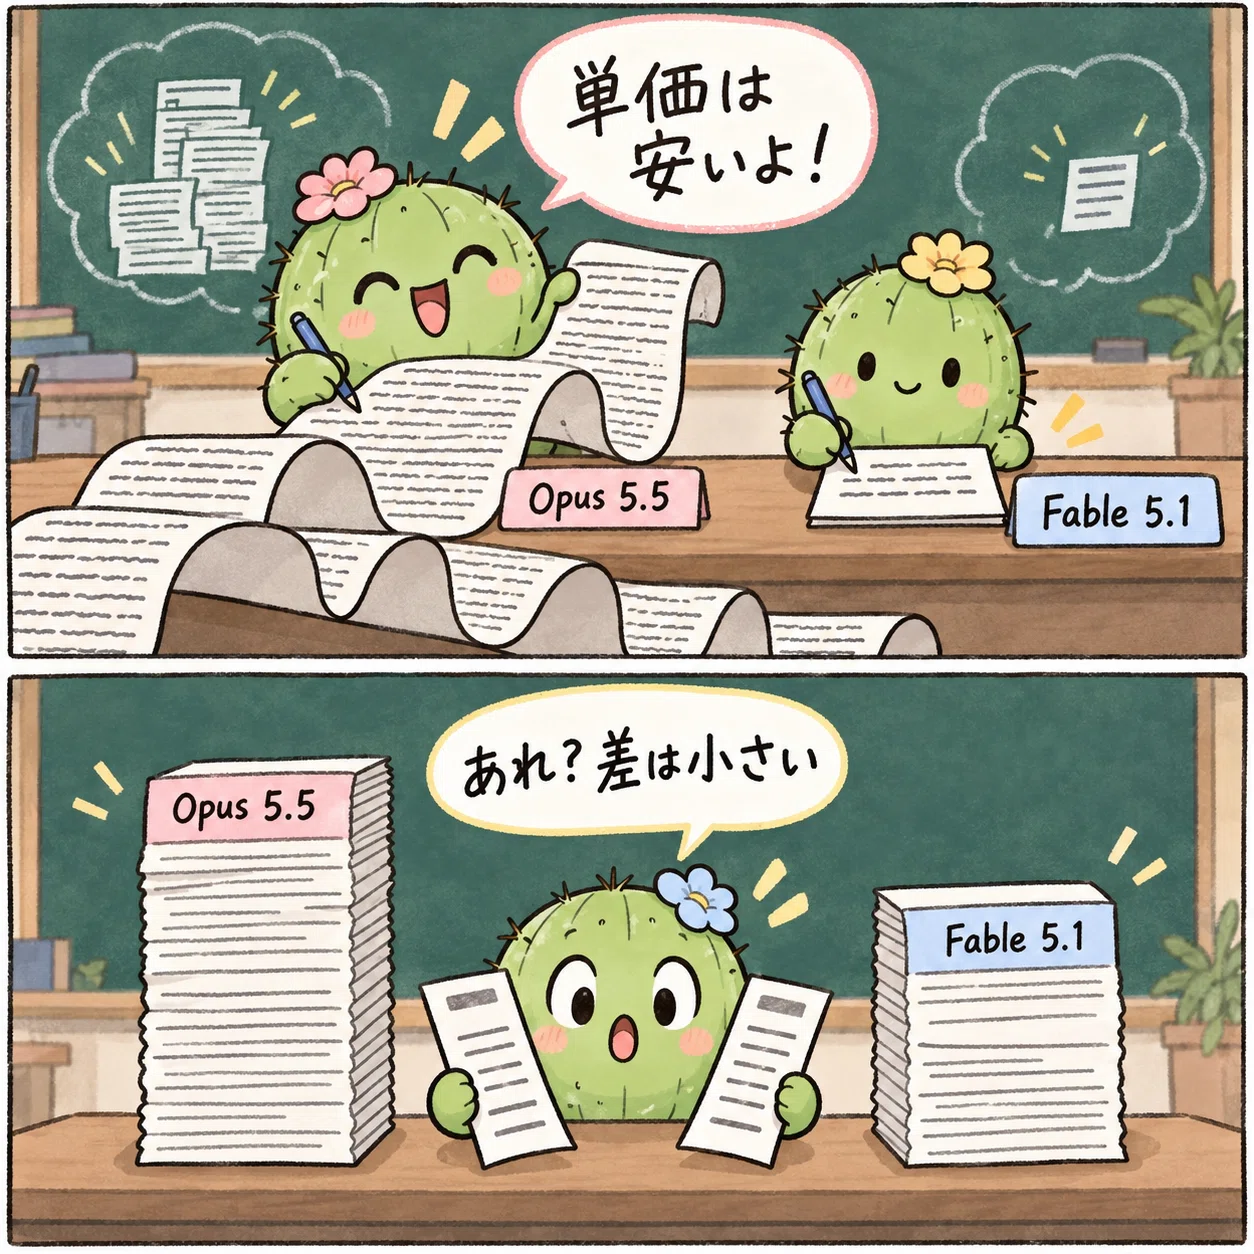
ところが、同じ仕事を1回やらせたときの実際の費用をくらべると、差は約22%まで縮みます。
なぜかというと、Opus 5.5のほうが答えを長く書くからです ✍️ 1文字あたりが安くても、たくさん書けば、そのぶんお金はかかりますよね。
もうひとつ大事なのが、月額プラン(ProやMaxなど)で使っている人の場合です。
月額プランは「定額」なので、60%安くなっても請求額は変わりません。 変わるのは「1か月に使える量の減り方」だけです。
「60%安い」は、主にAIを自分のサービスに組み込んで使う開発者のための話だと思っておくと、まちがいがありません 🙆
🏥 具体例:「町のお医者さん」と「大学病院の教授」
ここまでの話を、たとえで整理します。
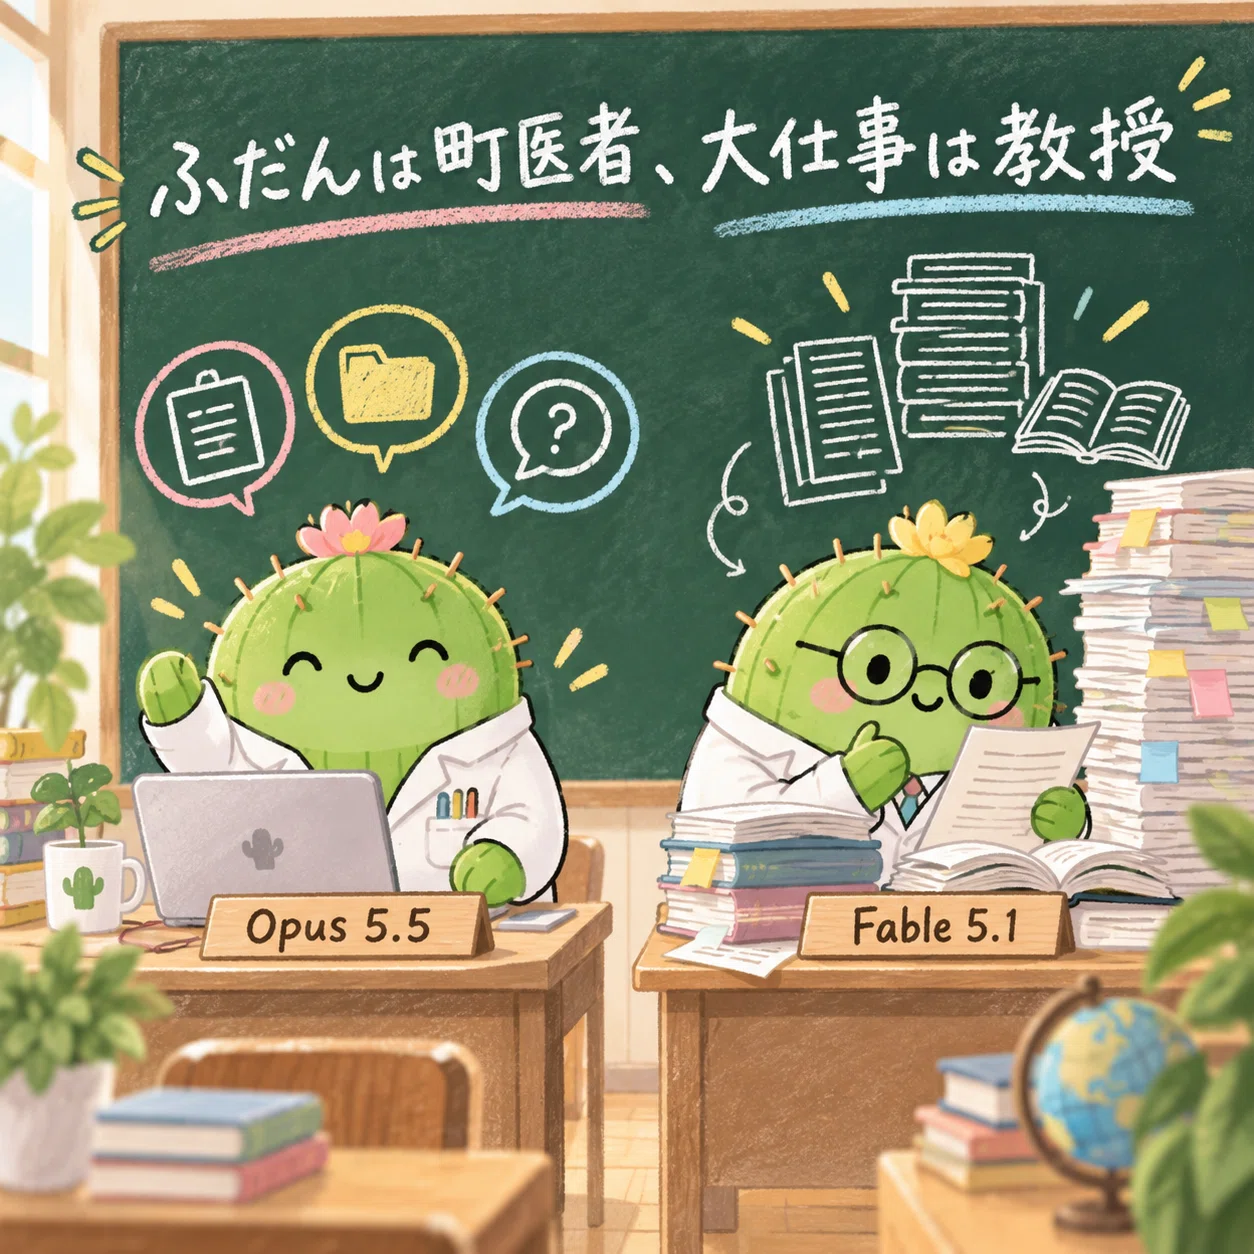
🩺 Opus 5.5は、腕のいい町のお医者さん。 かぜやケガ、健康診断のようなふだんの仕事をしっかりこなします。
🎓 Fable 5.1は、大学病院の教授。 ふだんの仕事もできますが、何時間もかかる大手術のような大仕事が得意です。
Opusも本気モードなら教授と互角か、それ以上。ただし、さらっと答えさせると教授に負けます。大手術のような仕事もできますが、そこはFableの出番です。
実際、Anthropicの公式の「モデルの選び方」のページ(Opus 5.5が出たあとに更新されたもの)にも、こう書かれています。
- 📝 たいていの仕事は、Opus 5.5から始める
- 🏗️ 何時間も続く作業・何段階もある深い調べもの・資料や表まで仕上げる仕事は、Fable 5.1
- ⬆️ Opusを最大の深さにしても足りないときは、Fable 5.1に上げる
ちなみに、書類を読み取るテストでは、今もFable 5.1が少しだけ勝っています(80.2点 対 78.9点)。 差は約1点なので、ふつうの使い方ではまず気にしなくて大丈夫です 👌
🤖 おまけ:AIに「どっちがすごい?」と聞いたら、AIも3回まちがえた話
じつはこの記事、AIに「Opus 5.5とFable 5.1、どっちがすごいの?」と聞いたところから始まりました。
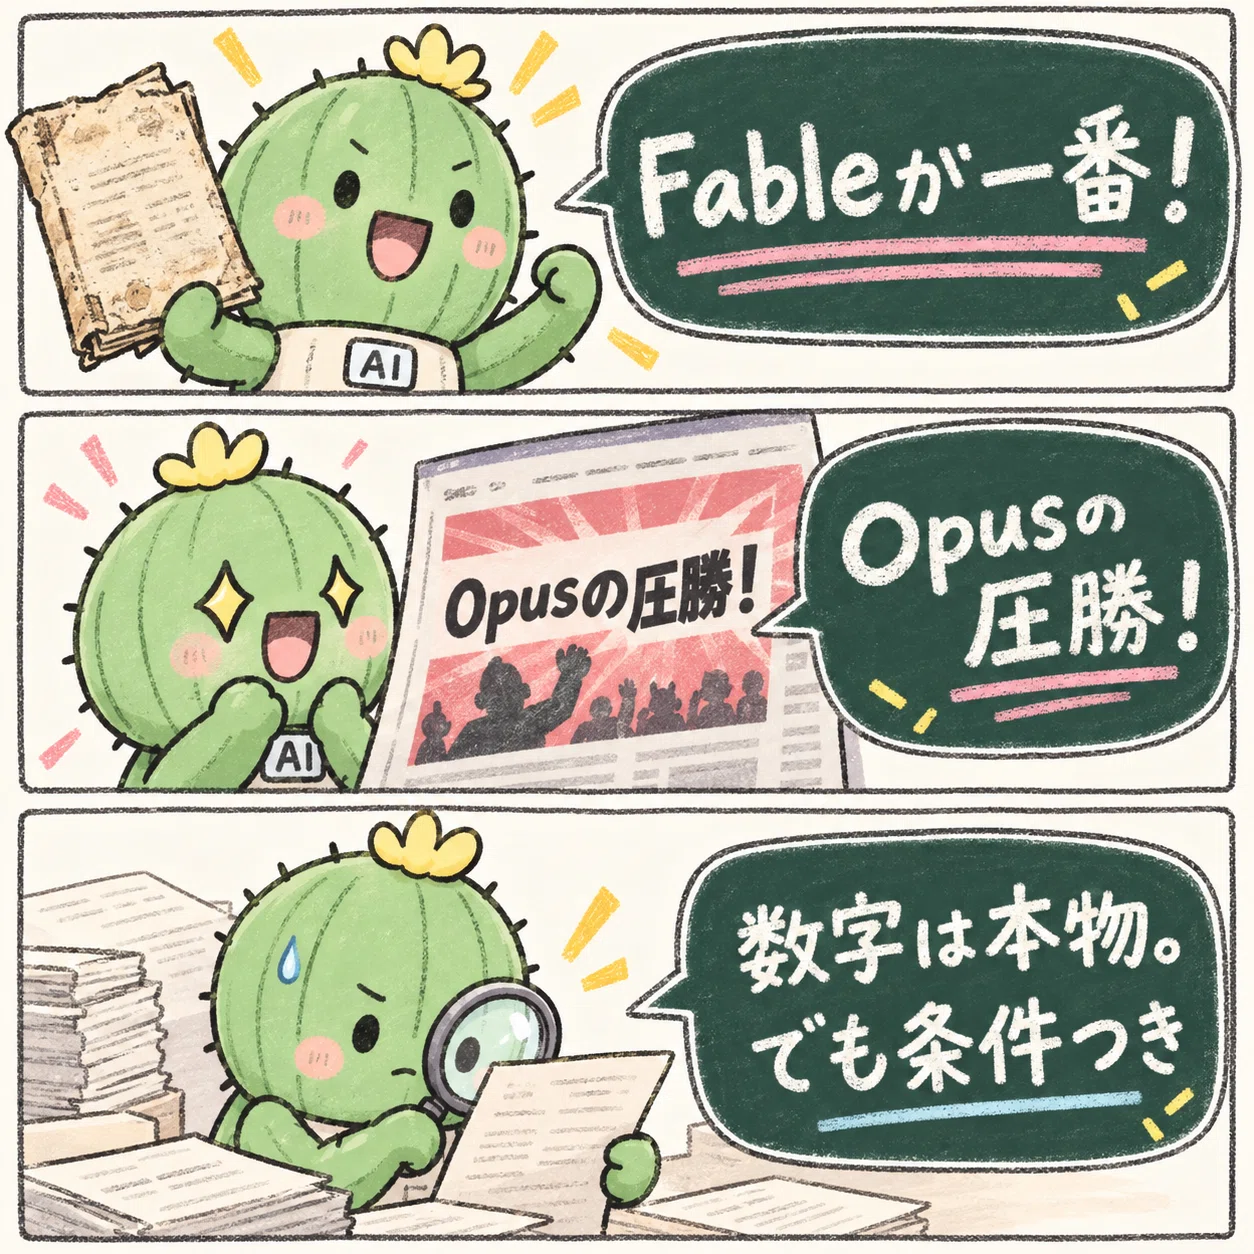
そのとき、AIの答えは3回ひっくり返りました 😅
1回目:「いちばん賢いのはFableです」
発売前の古い情報のまま答えていました。
2回目:「Opusの圧勝です。Fableはもういりません」
ニュースの見出しだけを信じて、逆に言いすぎました。
3回目:「数字は本物。でも条件つき。使い分けが大事」
公式の資料までさかのぼり、条件まで確かめた答えです。
つまり、AIも「条件」を確かめないと、まちがえるんです。
なので、AIにこういう比較を頼むときは、次のように聞くのがおすすめです 👇 (そのままコピーして使えます)
〔AIモデルAとB〕のどちらが優れているか調べてください。ただし次を守ってください。

1. ニュース記事ではなく、公式ページや採点機関のページで確かめてください。
2. 数字を出すときは「どの設定(考える深さなど)で測ったか」「定価か、実際の1回あたりの費用か」を必ず添えてください。
3. 主張ごとに「確認できた/一部正しい/確認できない/まちがい」の判定をつけてください。
4. 公式がすすめている使い分けがあれば、それも書いてください。
5. 分からないことは「分からない」と書いてください。中学生にも分かる言葉でお願いします。
ポイントは 2番 です。 「どの設定で測ったか」をセットにするだけで、今回のような「本気モードの時だけの数字」にだまされなくなります 🛡️
✅ まとめ:明日からの使い方はこれだけ
まずはOpus 5.5で始め、考える深さを「高」以上にします。Claudeアプリでは、チャットの入力欄にあるモデル名の横に、考える深さの設定が表示されます。
数時間続く制作や深い調査、2回つまずいた難問ではFable 5.1に切り替えましょう。仕事に合わせて選べば、毎回迷わずに済みます 🌵
⚠️ この記事の注意点
- 内容は 2026年9月27日時点のものです。Opus 5.5は9月22日に出たばかりで、点数や値段は今後変わる可能性があります(Fable 5.1も、発売日は66点だったのが、採点方法が変わって今は53点になっています)
- 外からの採点は、ほぼ1社(Artificial Analysis)のものです
- 日本語の文章や日本の事務作業でくらべたテストは、まだ見つかっていません
📚 参考にした資料
Anthropic「Claude Opus 5.5」発表ページ
https://www.anthropic.com/claude-opus-5-5
Anthropic「Claude Fable」ページ
https://www.anthropic.com/claude/fable
Anthropic 料金表
https://platform.claude.com/docs/en/about-claude/pricing
Anthropic「モデルの選び方」
https://platform.claude.com/docs/en/about-claude/models/choosing-a-model
Artificial Analysis「Opus 5.5 vs Fable 5.1」
https://artificialanalysis.ai/models/comparisons/claude-opus-5-5-vs-claude-fable-5-1
Artificial Analysis「Opus 5.5(中)vs Fable 5.1」
https://artificialanalysis.ai/models/comparisons/claude-opus-5-5-medium-vs-claude-fable-5-1
Artificial Analysis「Opus 5.5 考える深さ別の点数」
https://artificialanalysis.ai/models/releases/claude-opus-5-5