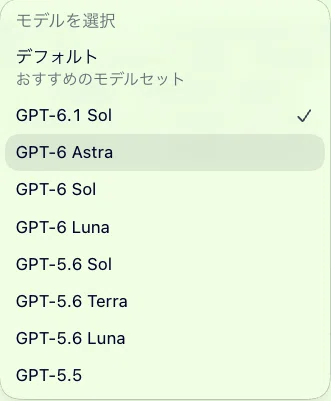
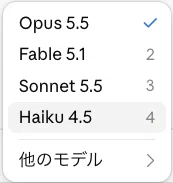
Codexの画面には「GPT-6.1 Sol」。Claudeの画面には「Opus 5.5」。
こう並ぶと、6.1のほうが新しくて強そうに見えませんか? ぼくも、2つの画面を見て、ChatGPTに聞きました。
「やっぱ数字がたかい 6.1がさいきょうなの?」
ところが、調べていくと、名前の数字とは別のところに差がありました。
🔢 「6.1」と「5.5」は、強さの点数ではありません
会社が違うAIの名前を、小数の大小だけで比べることはできません。
OpenAIとAnthropicが、同じ試験をして名前を付けているわけではないからです。 別のメーカーの車に「6」と「5」が付いていても、それだけで速さは分かりませんよね。
実際に見ていた画面が、こちらです。
ぼくは続けて、こう聞きました。
「claudeがわは5.5でだいぶ出遅れている?」
ここで大事なのは、5.5を「6.1より0.6点低い」と読まないことです。 名前は、その会社の製品を見分けるためのもの。会社をまたいだ成績表ではありません。
🧠 同じ試験で比べると、Opus 5.5が上の結果でした
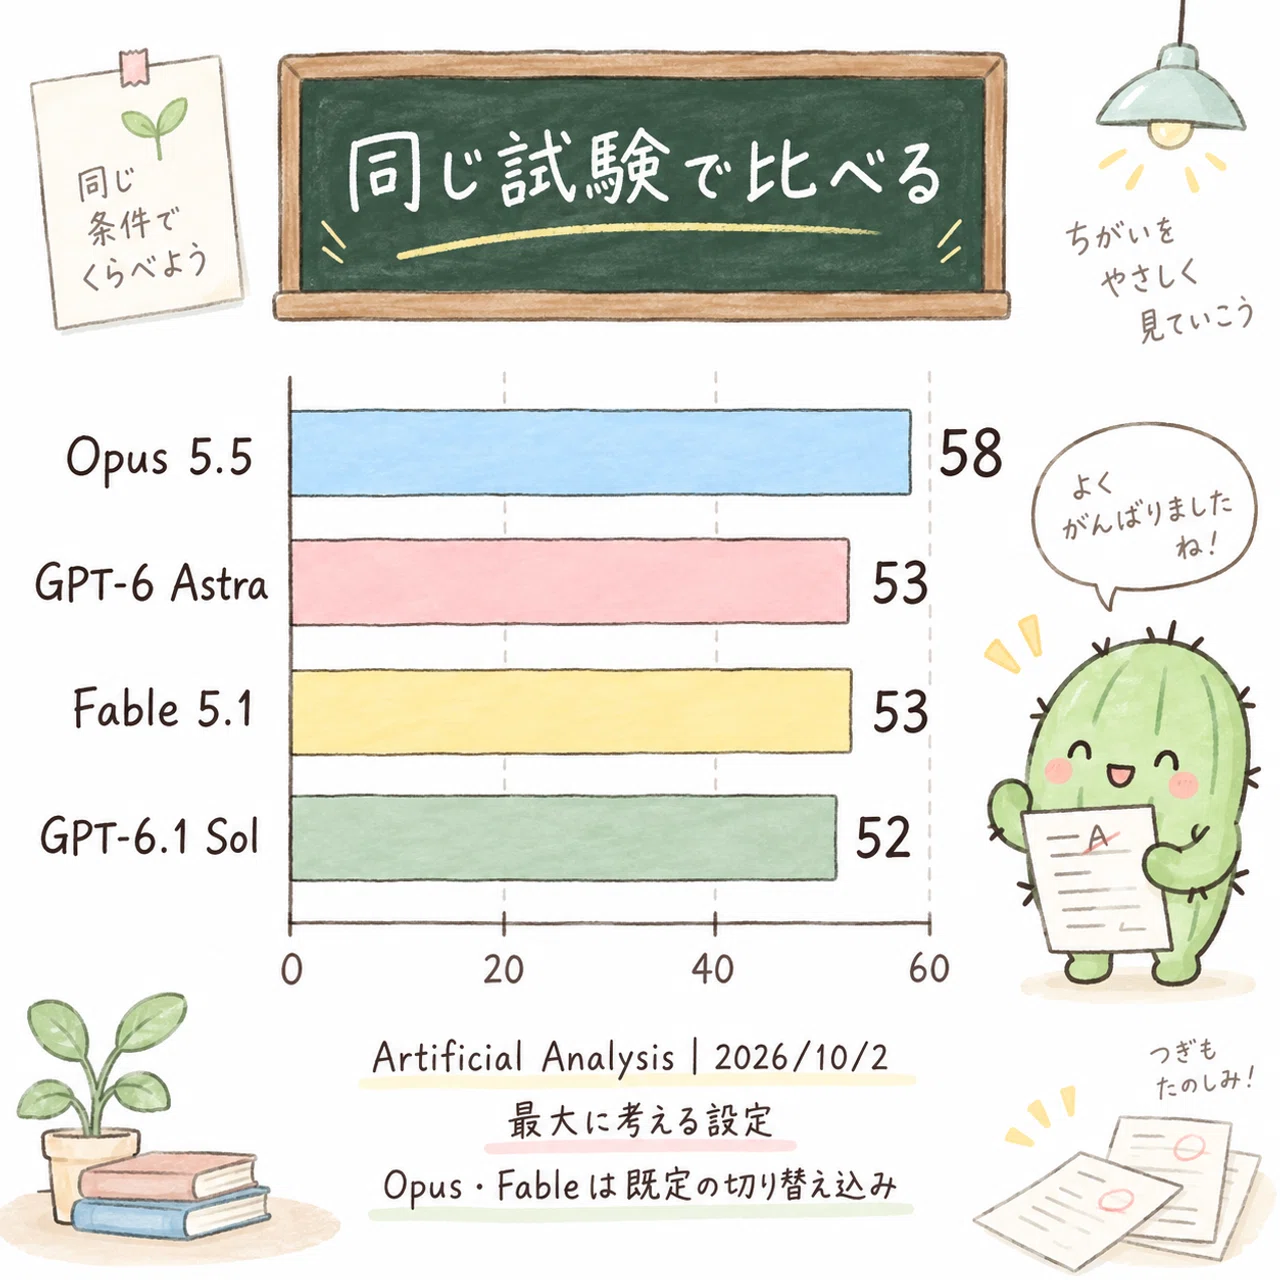
そこで見たのが、AIを作っている会社とは別の評価機関、Artificial Analysisの試験です。
※用語の補足①「ベンチマーク」=AIに決められた問題を解かせ、成績を比べる試験です。
2026年10月2日に確認した総合指標「Intelligence Index」では、次の数字でした。 考える量を最大にした設定の比較です。
Claude Opus 5.5:58。 今回比べた4種類では、いちばん高い数字です。
GPT-6 Astra:53。Claude Fable 5.1:53。 名前の5や6ではなく、この試験の結果では同じ整数の表示でした。
GPT-6.1 Sol:52。 名前の数字は大きくても、この総合指標ではOpus 5.5より下でした。
これは「58%の仕事に成功した」という意味ではありません。 いくつかの試験をまとめた指標で、数字が高いほど、その試験全体の成績が良いという読み方です。
なお、OpusとFableは、一部の問題で別のAIに切り替える既定の設定を含む結果です。 単体のAIだけを完全に同じ条件で測った数字、と受け取らないでください。
ここまで聞いて、ぼくは驚きました。
「現時点で最強はフェーブルでも Astraでもなく Opusですって??」
この試験の総合成績ではOpusが上。ただし、どんな仕事でも必ず勝つ、とは言えません。
国語の成績が良い人でも、すべての科目で1位とは限りませんよね。 AIも、頼む仕事が変われば、得意なほうが変わります。
Anthropic自身の発表にも、いくつもの業務を順番に進める試験では、AstraのほうがOpus 5.5より高い結果が載っています。 その発表では、多くの別の試験でOpusが上です。試験を変えると、順位も変わるんですね。 これはAnthropicが紹介した条件での比較です。先ほどの評価機関の総合指標とは分けて見ます。
今回の会話ではFableを「51前後」と説明されましたが、公開前の確認では「53」でした。 この記事と画像は、確認できた数字にそろえています。
総合指標は各モデルの評価ページで確認しました。仕事別の比較は、次の章にあるAnthropicの公式発表をもとにしています。
https://artificialanalysis.ai/models/claude-opus-5-5
https://artificialanalysis.ai/models/gpt-6-astra
https://artificialanalysis.ai/models/claude-fable-5-1
https://artificialanalysis.ai/models/gpt-6-1-sol
⛽ Opusの「燃費」は悪い?同じ量あたりの料金は2倍です
強さが分かると、次は使い続けられるかが気になります。
「オーパスって SOLより 燃費わるいの?」
ここでは「燃費」を、同じ量の文章を読み書きさせたときの料金として比べます。
※用語の補足②「API」=ほかのアプリや道具から、AIに仕事を頼むための入口です。ここで比べるのは、その入口を使う場合の料金です。
※用語の補足③「トークン」=AIが扱う文章を細かく区切った、料金などを数える単位です。「日本語1文字=1トークン」とは限りません。
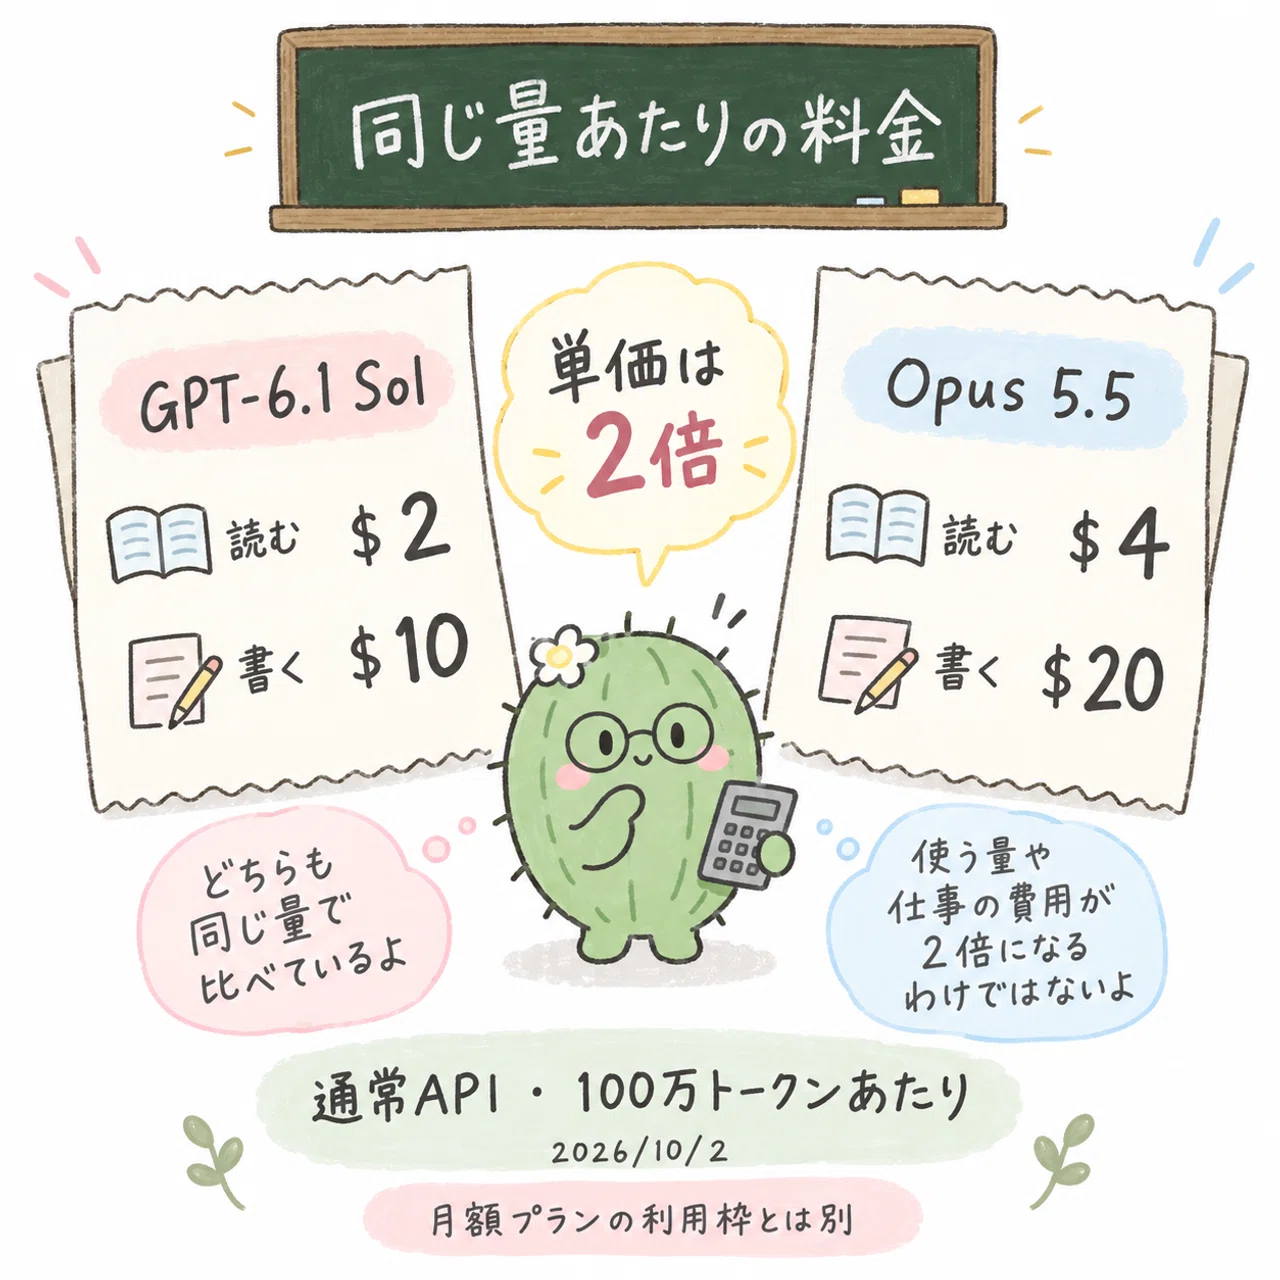
通常の文章のAPI料金は、100万トークンあたりで、こうなっています。
GPT-6.1 Sol:読む分が2ドル、書く分が10ドル。 読む分は渡した文章、書く分はAIが作る回答などにかかる料金です。
Claude Opus 5.5:読む分が4ドル、書く分が20ドル。 この単価だけなら、どちらもSolの2倍です。
たとえば、読む分を1万トークン、書く分を1,000トークンとして計算すると、Solは0.03ドル、Opusは0.06ドルになります。 これは料金表からの計算例で、ぼくが実際に払った金額ではありません。
https://developers.openai.com/api/docs/models/gpt-6.1-sol
https://www.anthropic.com/claude-opus-5-5
ただ、1件の仕事が終わるまでの料金は、単価だけでは決まりません。 渡す文章の量、AIが考えたり答えたりする量、やり直しの回数でも変わります。
「1枚のコピー代は安いけれど、何度も刷り直した」ということもありますよね。 だから、単価が半分だから、完成までの費用も必ず半分とは限りません。
ここでの比較は、2026年10月2日時点の通常API単価です。 高速の設定、非常に長い入力、前に渡した文章を再利用する割引、追加の道具の料金などは、上の計算に含めていません。 ChatGPTやClaudeの月額プランで「残りの利用枠が2倍減る」と確認した数字でもありません。
🛠️ 自分の仕事なら、同じ依頼を1つ試すと分かります
ここまでの数字は、候補を絞るための材料です。 最後は、いつもの仕事を1つだけ選び、同じ条件で試してみます。
たとえば、個人情報を含まない短い記事の下書き。 同じ文章を渡して、「意味を変えずに、読みやすく直してください」と頼みます。
それぞれの答えを見て、直してほしいことが何回あったか、使える形になるまで何分かかったかをメモします。 APIで試す人は、実際の利用明細も確認します。月額プランの人は、残りの利用枠を見ます。
この試し方は、読者向けの提案です。 今回ぼくが両方で仕事を実行し、勝ち負けを測った記録ではありません。
誰がいちばん強いかを決めるより、「この仕事なら、少ない手直しで終わるのはどちらか」。 そこまで見えると、自分の主力を選びやすくなります 😊