「仕事のコードをそのままAIに任せたい。でもGoogle・Anthropic・OpenAIの3社、結局どれがいちばん強いの?」── そんな疑問に、2026年4月時点の最新ベンチマークと実用性から結論をお出しします。🏁
📚 目次
結論:Claude Opus 4.7 が第一候補です
なぜ Claude なのか:3つの理由
3社のステータスを比較してみました
用途別・2軍として使うならこう組むのがおすすめ
まとめ
🏆 結論:Claude Opus 4.7 を選びます
👑ブリーダーの結論
会社の実コードをエージェントに任せるなら、最重要なのは「派手さ」ではなく「壊さないこと」です。その観点で2026年4月現在、頭ひとつ抜けているのが Anthropic の Claude Opus 4.7 です。
💡 なぜ Claude なのか:3つの理由
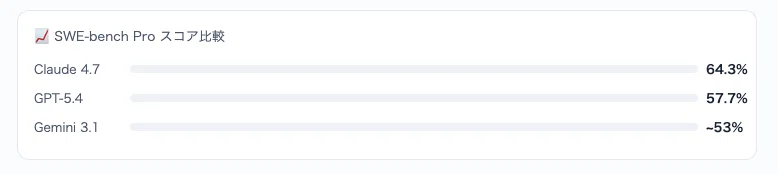
理由1:SWE-bench で2026年4月時点の首位です 📊
実コードのバグ修正タスクを集めたベンチ「SWE-bench Verified」で 87.6%、より難しい「SWE-bench Pro」でも 64.3% を記録し、GPT-5.4(57.7%)や Gemini 3.1 Pro(80.6%)を明確に上回っています。
理由2:ツールエラーが前世代の3分の1に減っています 🔧
Opus 4.7 は前バージョン(4.6)比で、複雑な多段ワークフローの成功率が 14%向上し、ツール呼び出しのエラーが約1/3まで減ったと発表されています。エージェントを長時間放置して走らせる運用では、この「途中でコケない」性質が決定的に効いてきます。
理由3:複数ファイルをまたいだリファクタが一番得意です 🧩
複数ファイルに散らばった変更を一貫したルールで書き換える、いわゆる「横断リファクタ」は、実務コードでいちばん事故りやすい作業です。複数の独立ベンチマーク比較で Claude Code は first-pass correctness 約92%と、この領域で他2社を引き離しています。
✍️ ポイント:ベンチの数字より大事なのは「自分のリポで動かしたときの事故率」です。Claude はその体感が最も良い、というのが各種レビューでの共通見解です。
⚔️ 3社のステータスを比較してみました
それぞれの得意分野をモンスターファーム風のステータスカードにまとめました。✨
A
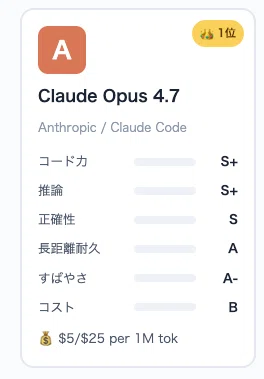
Claude Opus 4.7
Anthropic / Claude Code
コード力S+
推論S+
正確性S
長距離耐久A
すばやさA-
コストB
💰 $5/$25 per 1M tok
G
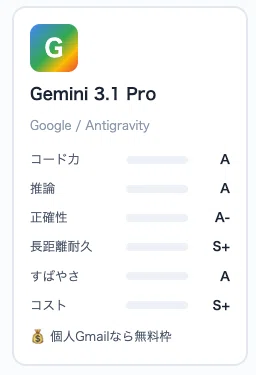
Gemini 3.1 Pro
Google / Antigravity
コード力A
推論A
正確性A-
長距離耐久S+
すばやさA
コストS+
💰 個人Gmailなら無料枠
O
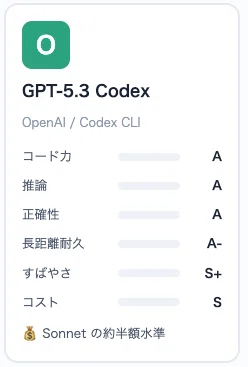
GPT-5.3 Codex
OpenAI / Codex CLI
コード力A
推論A
正確性A
長距離耐久A-
すばやさS+
コストS
💰 Sonnet の約半額水準
📋 主要ベンチを表にまとめました
指標Claude 4.7Gemini 3.1 ProGPT-5.3 Codex / 5.4SWE-bench Verified87.6%80.6%-SWE-bench Pro64.3%~53%57.7%Terminal-Bench--75.1%コンテキスト窓200K1M400K無料枠△◎(Antigravity)◯
🎯 用途別・2軍として使うならこう組むのがおすすめです
実際の業務では1体に絞らず、得意分野で使い分けるのが最も生産的です。以下の3パターンで考えてみてください。
🧠 メイン運用
複雑な実装・大改修
本業の仕事コードは Claude Code にお任せするのが安全です。多ファイル改修で壊さない信頼性が最優先。
📚 大規模把握
モノリポ全読み・ブラウザ自動化
巨大なコードベースを丸呑みしたい、ブラウザ操作まで任せたい場面では Gemini 3(Antigravity) の1M窓が効きます。
⚡ 高速処理
小粒タスクを大量に
ターミナル上の小さな修正を数をこなす系は GPT-5.3 Codex がコスパ最強です。Claude の待ち時間に走らせましょう。
🔀 併用の考え方:「重要な実装はクロード、周辺雑務はコデックス、全体俯瞰はジェミニ」という三刀流が、2026年春時点のバランスの取れた布陣です。
📝 まとめ
今日の1点まとめ 🎁
最後までお読みいただき、ありがとうございました。🙏 あなたの会社での選定のヒントになれば嬉しいです。
📚 参考にした情報源